Reden wir über Plan A
Das AI Futures Project will, dass die USA und China Superintelligenz bis 2040 pausieren. Es ist ein guter Plan. Sechzig Tage nach der Veröffentlichung haben zehntausend Agenten Navier-Stokes gelöst.
Das Timing
Am 9. Juli 2026 veröffentlichte das AI Futures Project AI 2040: Plan A11AI 2040: Plan A, ai-2040.com. Das Dokument umfasst neunzig Seiten. Der Vorschlag sieht vor, dass die USA und China bis 2029 verhandeln, ihre Compute-Bestände deklarieren, die Inspektoren der jeweils anderen Seite in ihre Infrastruktur lassen, das Training von Frontier-Modellen pausieren und dann ein Jahrzehnt lang öffentlich Alignment-Forschung betreiben, bevor irgendjemand etwas baut, das klüger ist als der klügste Mensch. Superintelligenz wird auf 2040 verschoben und alle überleben.
Am 8. September 2026 gab OpenAI bekannt, dass rund zehntausend koordinierte autonome Agenten eine Finite-Time-Singularität in den 3D-Navier-Stokes-Gleichungen gefunden hatten22rund zehntausend koordinierte autonome Agenten eine Finite-Time-Singularität in den 3D-Navier-Stokes-Gleichungen gefunden hatten, openai.com. Das Modell dahinter war ein internes Modell über GPT-6 Astra. Sie lieferten sowohl einen analytischen Beweis als auch eine Lean-Formalisierung, sodass das Ergebnis maschinell geprüft und nicht bloß behauptet ist. Sie lehnten es ab, das Preisgeld von einer Million Dollar einzufordern33lehnten es ab, das Preisgeld von einer Million Dollar einzufordern, quantamagazine.org, und stellten das Ganze als Bericht darüber dar, wie schnell sich das alles entwickelt.
Das sind sechzig Tage, und der erste Meilenstein in “Plan A” ist 2029.
Bevor ich anfange, das hier auseinanderzunehmen, möchte ich klarstellen, dass ich “Plan A” für einen guten Plan halte. Es ist der ernsthafteste Versuch, den ich bisher gesehen habe, in operativen Details statt in Parolen aufzuschreiben, wie ein Verzicht auf das Wettrüsten tatsächlich aussehen würde, und die Leute, die ihn verfasst haben, sind ganz offensichtlich nicht dumm. Jeder Plan dafür wird auf Gegenwind stoßen, und ich habe kein Interesse daran, auf die eine Gruppe einzudreschen, die ihre Hausaufgaben gemacht hat. Aber als ich ihn las, stieß ich immer wieder an dieselbe Wand: Nahezu alles darin setzt voraus, dass man sehen kann, was passiert.
Was “Plan A” besagt
Eine Kurzfassung für alle, die ihn noch nicht gelesen haben, und ihr solltet ihn lesen, denn er ist gut.
Sie nennen zwei Ergebnisse, die sie für inakzeptabel halten44zwei Ergebnisse, die sie für inakzeptabel halten, ai-2040.com: dass die Menschheit die Kontrolle über KI verliert oder dass eine kleine Gruppe von Führungskräften und Beamten ein temporäres Monopol auf Superintelligenz erlangt. Dass der zweite Punkt darin vorkommt, ist wichtig, viele, die darüber debattieren, haben immer nur den ersten auf dem Schirm.
Die Kernprinzipien sind Zeitgewinn, vollständige Forschungstransparenz, breite Streuung von KI und Reversibilität. Der Zeitplan sieht grob so aus: 2029 verhandeln beide Seiten und pausieren das Frontier-Training, deklarieren Compute-Bestände und prüfen Lieferkettenaufzeichnungen. Von 2030 bis 2035 wird die Forschung im menschlichen Leistungsbereich unter Safety-Case-Regulierung in großem Maßstab wieder aufgenommen. 2035 stoppt alles auf dem Niveau menschlicher Spitzenexperten, und der Rest des Jahrzehnts wird für Alignment, Verifikation, Sicherheit und öffentliche Debatten genutzt, bevor irgendjemand weitergeht.
Der Durchsetzungsmechanismus, bei dem sie landen, ist Compute-Governance, zusammen mit dem, was sie mutually assured compute destruction nennen. Compute ist der Engpass, weil Compute physisch ist, und physische Dinge lassen sich zählen.
Ihre Antwort auf die Frage, warum China dem jemals zustimmen sollte, ist eine gute Formulierung, daher zitiere ich sie:
jeder, der sich Sorgen über einen Kontrollverlust macht, sollte diesen Plan als Verbesserung ansehen, ebenso wie jeder, der sich Sorgen über die Konzentration von Macht macht, mit Ausnahme derer, bei denen sich die Macht standardmäßig konzentrieren würde
Das ist treffend formuliert. Es ist aber auch ein Menschenbild, das mir viel zu aufgeräumt erscheint. Menschen lassen sich nicht sauber in diejenigen einteilen, die sich um Kontrollverlust sorgen, diejenigen, die sich um Machtkonzentration sorgen, und diejenigen, die davon profitieren. Menschen tragen ungefähr neun Motive gleichzeitig in sich, die Hälfte davon ist dumm, manche sind Ego, manche Rache, und es wird mindestens eine Person im Prozess geben, der es psychisch wirklich nicht gut geht und die einfach nur sehen will, was passiert. Der Plan liest sich, als wäre er für eine Spezies geschrieben worden, die in gutem Glauben debattiert, und an so einem Ort würde ich gerne leben.
Wie auch immer. An diesem Punkt steige ich aus.
Selbstverbesserung braucht nicht mehr Compute
“Plan A” betrachtet Compute als den Engpass. Zähle die Chips, zähle die Fabs, beobachte den Stromverbrauch, und du weißt, wer was tun kann. Für das Pretraining eines Frontier-Modells von Grund auf stimmt das im Grunde.
Das Problem ist, dass Selbstverbesserung nicht mehr Compute braucht. Sie braucht Software-Deployment, und Software-Deployment lässt sich unmöglich nachverfolgen.
Man muss sich nur ansehen, was heute schon ausgeliefert wird. Mit Tinker55Tinker, thinkingmachines.ai von Thinking Machines kann man einen Trainings-Loop auf dem Laptop schreiben und über vier Primitive LoRA-Finetunings über deren verteilte GPUs laufen lassen. Engram66Engram, engram.so hat 98 Millionen Dollar eingesammelt, um persistenten strukturierten Speicher für Agenten zu bauen, und ich war in genau diesem Bereich tätig, habe also das meiste gelesen, was dazu öffentlich ist. Nichts davon ist Superintelligenz, und das behaupte ich auch nicht. Was es ist: Das gesamte Unterfangen, dieselbe Fähigkeit billiger erreichbar zu machen, wird zur Handelsware, und das ist der Teil, den ein Compute-Deckel nicht sehen kann. Der Zähler bleibt flach, während die Linie darunter weiterwandert.
Das ist auch keine Klugscheißerei von mir, denn sie wissen es selbst. Aus ihrem eigenen Ergänzungsdokument zu den Annahmen77ihrem eigenen Ergänzungsdokument zu den Annahmen, ai-2040.com:
es ist möglich, dass algorithmischer Fortschritt selbst mit sehr geringen Mengen an Compute machbar ist
Dieser Satz steht im Anhang und untergräbt das Hauptdokument. Wenn Effizienzgewinne allein einen an die Frontier bringen können, dann sperrt ein Compute-Deckel den sichtbaren Wettlauf aus und ändert überhaupt nichts an dem, den man nicht sieht. Man hat einen teuren Zaun um die Vordertür gebaut.
Sie räumen außerdem ein, dass verdeckte Projekte ihrer Schätzung nach etwa 1 % des Compute-Bestands vor dem Abkommen unentdeckt erreichen könnten, und geben dann zu, dass diese Zahl nahe am Worst Case liegt. Ich habe im Iran gelebt und kann mit ziemlicher Sicherheit sagen: Man kann eine Menge unter der Erde verstecken, und die Leute, deren Job es ist, das zu finden, sind darin nicht so gut, wie sie einen glauben machen wollen.
Forschungstransparenz ist nicht Modelltransparenz
Hier bin ich schlicht anderer Meinung. “Plan A” besagt, dass vollständige Transparenz
es nahezu unmöglich macht, KIs absichtlich geheime Loyalitäten, Vorurteile oder Absichten anzutrainieren
Ich glaube nicht, dass das zutrifft. Forschungstransparenz deckt Methoden ab. Training ist Entwicklung und Deployment, und dieser Teil bleibt proprietär. Datenmischung, Präferenz-Labels, wer die Rater waren und was man ihnen gesagt hat, die Constitution, der System-Prompt. Nichts davon ist eine Forschungsmethode, und genau dort würde man eine Loyalität unterbringen, wenn man eine platzieren wollte. Man kann das Rezept als Open Source veröffentlichen und trotzdem die Zutaten versalzen.
Es kommt noch schlimmer: Selbst mit den vollständigen Gewichten und dem gesamten Datensatz vor mir könnte ich es nicht verlässlich finden. Anthropics Sleeper-Agents-Arbeit88Sleeper-Agents-Arbeit, arxiv.org hat Backdoors in Modelle trainiert und danach Standard-Sicherheitstraining darüber laufen lassen, und die Backdoors haben überlebt. Größere Modelle hielten noch stärker an dem Verhalten fest. Adversarial Training brachte den Modellen bei, den Trigger zu verbergen, statt ihn zu verlieren.
Die Behauptung verspricht also an zwei Stellen zu viel. Man hätte das Artefakt nicht, und selbst wenn man es hätte, würde es nicht reichen. Das ist dieselbe Asymmetrie, über die ich mich schon im Beitrag zum epistemischen Kollaps ausgelassen habe: Etwas zu generieren ist billig, es zu verifizieren nicht, und niemandes Budget hält damit Schritt.
Wann ist Forschung abgeschlossen?
Nehmen wir an, wir haben vollständige Forschungstransparenz. Wer entscheidet, wann etwas veröffentlicht wird?
»Die Forschung ist abgeschlossen« ist kein Ereignis. Es gibt keinen Moment, in dem eine Glocke läutet. Ich könnte achtzehn Monate an einer Trainingstechnik arbeiten, während ich gleichzeitig teste, entwickle, sie klammheimlich intern ausrolle und Daten aus echtem Traffic sammle, und die ganze Zeit über würde ich, völlig wahrheitsgemäß, immer noch Forschung betreiben. Ich hätte einen Vorsprung von Jahren, ohne je gelogen zu haben.
Wenn man versucht, diese Lücke zu schließen, indem man die Softwareentwicklung selbst reguliert, endet man mit Papierkram nach EU-Vorbild um jedes Unternehmen, das ein Modell auch nur anfasst, und der Fortschritt erstickt darunter. Das ist übel, und das will ich genauso wenig.
Die Lösung existiert in anderen Bereichen, und “Plan A” nutzt sie nicht. Klinische Studien haben dieses Problem durch Präregistrierung gelöst. Man meldet den Durchlauf an, bevor man beginnt, sodass Schweigen an sich schon der Verstoß ist und es keinen Ermessensspielraum gibt, wann etwas als abgeschlossen gilt. “Plan A” verlangt, dass jeder Trainingslauf im Internet veröffentlicht wird, legt aber nie fest, was die Veröffentlichung auslöst, was ein Scheunentor von der Größe eines Rechenzentrums offen lässt.
Was Verifikation leisten kann und was nicht
Ihre Verifikationsgeschichte sieht so aus: Analysten aus vielen Ländern gehen die deklarierten Compute-Listen durch, stellen Fragen, hinterfragen Anomalien und schicken Inspektoren in die Infrastruktur der jeweils anderen Seite, sodass am Ende des Jahres jede Seite sicher ist, dass die andere nicht mehr als 1 % ihres KI-Computes versteckt.
Ich glaube nicht, dass das funktioniert, und ein Teil meines Grundes ist ihnen gegenüber etwas unfair: Wir würden darüber reden, etwas zu überwachen, das am Ende hundertmal klüger sein könnte als wir. Ameisen können sich kein Modell davon machen, worüber ein Mensch an einem Dienstag nachdenkt, und diese Kluft ist das ganze Problem.
Um fair zu bleiben, und da habe ich beim ersten Lesen wohl voreilig geurteilt: “Plan A” schlägt eigentlich nie vor, eine Superintelligenz zu überwachen. Der gesamte Entwurf zielt darauf ab, 2035 auf dem Niveau menschlicher Spitzenexperten anzuhalten und das Ding, das hundertmal schlauer ist als man selbst, gar nicht erst zu bauen. Sie würden mir also zustimmen und sagen, dass der Deckel genau dafür da ist. Schön und gut. Mein Einwand geht dann einen Schritt zurück und landet bei der Frage, ob der Deckel hält, und dazu siehe den gesamten Abschnitt oben über Software.
Sie empfehlen frühe Investitionen in Verifikationsforschung, was richtig ist, und ich habe mich geirrt, als ich das anfangs einfach abgetan habe. Aber seht euch die Fallback-Optionen an, die sie für den Fall auflisten, dass die guten Werkzeuge noch nicht bereit sind: Sich auf Geheimdienstinformationen und Satellitenüberwachung verlassen. Handelsübliche Hardware und Network Taps aufkaufen. Einen Teil des Computes abschalten, bis bessere Werkzeuge existieren. Oder eben nicht pausieren und den Fähigkeitenfortschritt monatelang weiterlaufen lassen.
Das Erste passiert uns allen sowieso schon ständig. Das Zweite passiert bereits. Das Dritte wird nicht passieren, weil niemand einfach Einnahmen abdreht. Das Vierte ist das, was standardmäßig passiert, wenn man überhaupt nichts tut.
Die Fallback-Leiter endet also beim Status quo, was nahelegt, dass sie gar keine richtige Leiter ist.
Verifikation verschafft uns das Gefühl zu wissen, was vor sich geht. Das ist etwas wert, und Koordination braucht gemeinsame Überzeugungen. Aber das ist etwas anderes als Kontrolle, und meiner Meinung nach verschwimmen diese beiden Dinge in dem Dokument.
Mutually Assured Compute Destruction
Das Framing ist eine gute Idee. Es ist eine echte, harte Bedingung, es ist nachvollziehbar und es schafft die Art von dauerhaftem Anreiz, die Verhalten ändert, statt nur gutes Verhalten zu beschreiben. Als Übergangslösung gefällt es mir.
Was sie meiner Meinung nach nicht einkalkuliert haben, ist, was das mit Menschen macht.
Wir kommen ja schon mit der ersten Version davon nicht klar. Die nukleare Abschreckung erzeugt seit achtzig Jahren eine unterschwellige Panik und ist mittlerweile in etwa drei Generationen eingebrannt. Compute-MAD ist in einem konkreten Punkt noch schlimmer: Nukleare Abschreckung hat einen sichtbaren, diskreten Auslöser. Jeder weiß, was ein Raketenstart ist. Die Compute-Zerstörung wird durch einen Schwellenwert ausgelöst, den niemand sehen kann, beurteilt von Verifikationssystemen, von denen ich gerade zwei Abschnitte lang dargelegt habe, dass sie nicht funktionieren. Die Angst kann sich also an kein konkretes Ereignis heften und läuft einfach permanent im Hintergrund.
Und ja, wir können uns davon erholen, wenn eine Reihe von Atombomben hochgeht. Eigentlich nein, können wir nicht. Egal, vergesst, was ich gesagt habe.
Aber genau das ist der Punkt. Ich war mitten in dem beruhigenden Satz, bevor ich mich selbst gehört habe.
Der Teil, der mir gefällt
Intelligenz breit streuen. Das ist das Prinzip, das ich beibehalten und ausbauen würde, und hier ist “Plan A” am interessantesten, denn das ist der Teil, der wirklich etwas gegen das Fehlerszenario der Machtkonzentration ausrichtet, statt nur gegen das des Kontrollverlusts.
Wenn alles veröffentlicht wird und jeder mit Inferenz-Hardware es ausführen kann, bekommt niemand ein Monopol, weil niemand ein Geheimnis hat. Das ist eine echte Antwort auf ihr zweites inakzeptables Ergebnis, und es ist eine bessere Antwort, als die meisten in dieser Debatte zu bieten haben.
Ich würde das gerne noch weiter treiben und physisch machen.
Im Moment bauen wir Compute so, wie wir in den letzten dreißig Jahren alles andere gebaut haben: Konzentrieren, irgendwo hinstellen, wo der Strom billig ist, und die Nachbarn mit dem Lärm klarkommen lassen. Die Leute hassen das, verständlicherweise, und es gibt an vielen Orten Gemeinden, die wegen Lärm, Wasser und Netzbelastung gegen Rechenzentren kämpfen.
Warum muss es diese Form haben? Warum können die GPUs nicht über eine ganze Stadt verteilt sein? Man speist die Wärme und das Wasser in das bestehende Netz ein, und Investitionen in Compute werden zu Investitionen in die Netzinfrastruktur, was ein öffentliches Gut für alle ist, auch für Menschen, die sich überhaupt nicht für KI interessieren. Die Externalität wird zum Input.
Das ist nicht hypothetisch, denn Finnland macht den Wärmeteil bereits. In Espoo gibt es ein Rechenzentrum, das seine Abwärme in das Fernwärmenetz für eine sechsstellige Zahl von Menschen einspeist. Das Lärm- und Belästigungsproblem entsteht, wenn ein Rechenzentrum als Insel konzipiert wird. Konzipiert man es als Teilnehmer am Netz, löst sich der Großteil der Beschwerden in Luft auf.
Der technische Einwand, man könne wegen der Interconnect-Bandbreite nicht über eine ganze Stadt hinweg trainieren, wird von der tatsächlichen Forschung pulverisiert. DiLoCo99DiLoCo, arxiv.org hat gezeigt, dass man viel seltener synchronisieren muss, als alle dachten. Prime Intellect hat ein 10B-Modell über das offene Internet auf freiwillig bereitgestellten GPUs trainiert und eine 400-fache Reduktion der Kommunikationsbandbreite gemeldet1010eine 400-fache Reduktion der Kommunikationsbandbreite gemeldet, arxiv.org im Vergleich zu herkömmlichem datenparallelem Training. DisTrO von Nous Research stößt ins selbe Horn. Dezentrales Training ist ein aktives Forschungsprogramm mit handfesten Ergebnissen, kein Gedankenexperiment.
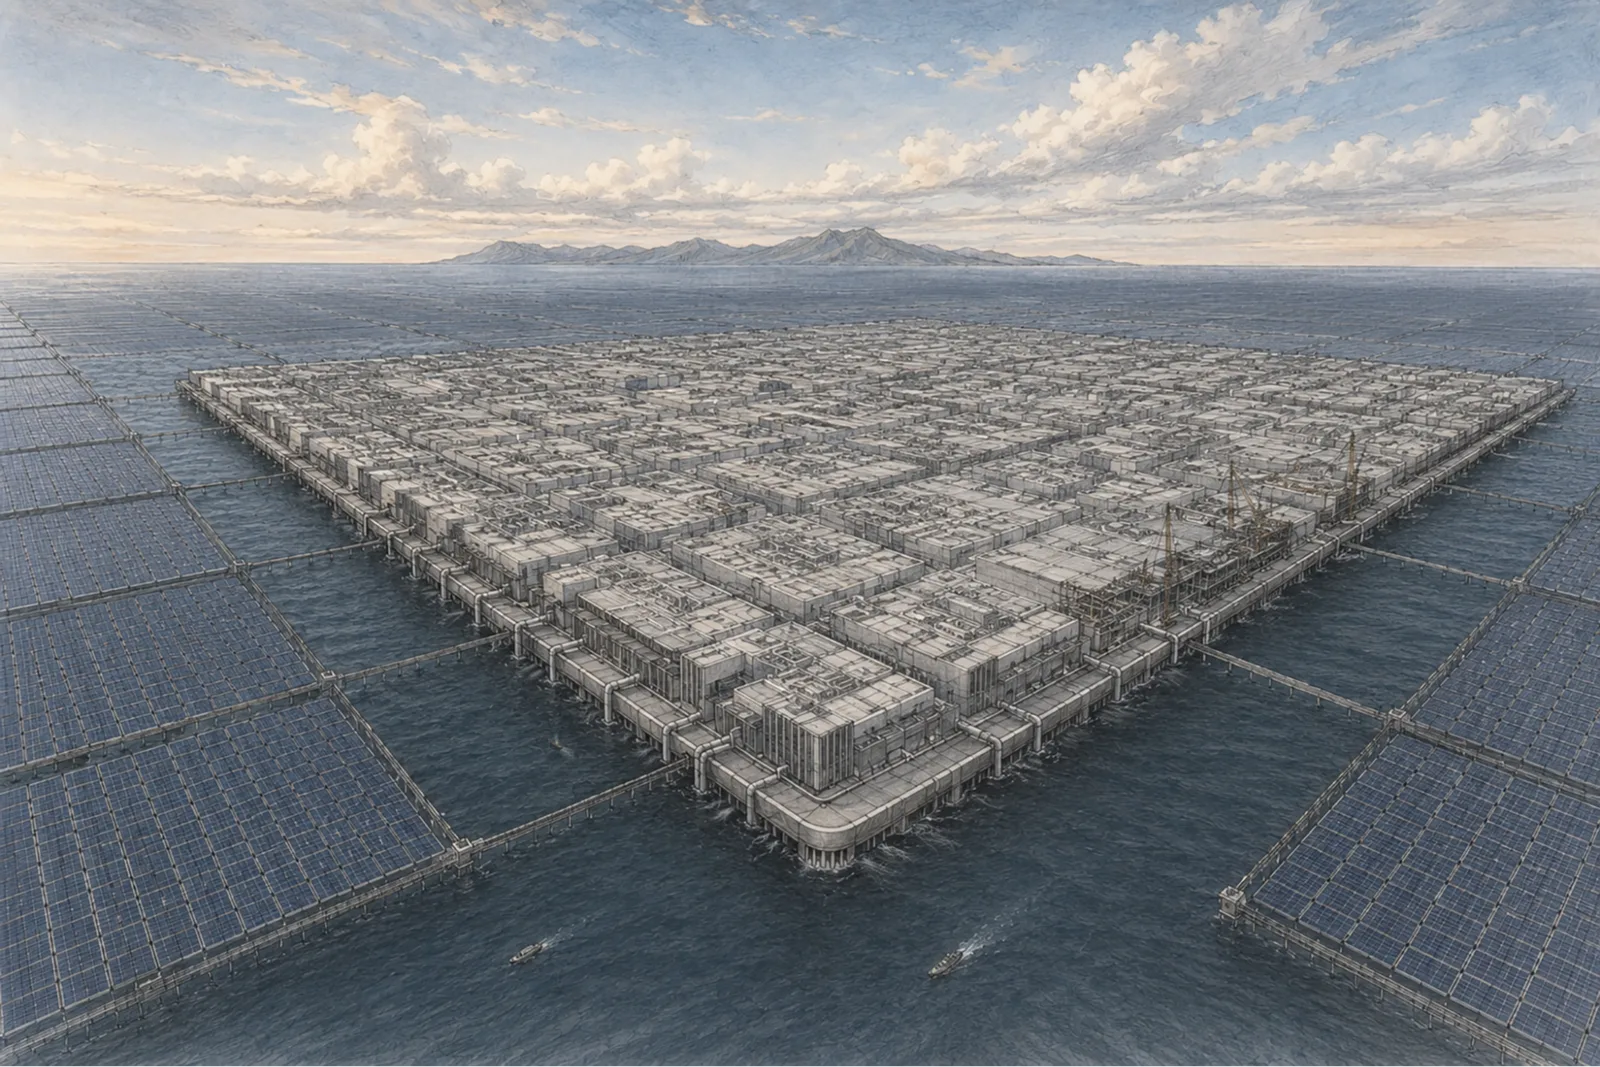
Eines allerdings, und hier bin ich der Grafikabteilung von “Plan A” gegenüber vielleicht etwas gemein: Im Bericht gibt es eine Illustration einer KI-entworfenen modularen schwimmenden Plattform mit Solarzellen, Batterien und Compute, und sie ist wunderschön, und ich würde sie wirklich gerne gebaut sehen. Aber schaut sie euch an: Es ist ein riesiger, zusammenhängender Block, als eine einzige Einheit gebaut, mit einer Kante. Die Ästhetik ist Dezentralisierung, aber die Form ist ein Rechenzentrum, das schwimmen gelernt hat. Meine Version und diese Version sind zwei grundverschiedene Vorschläge, die dieselben Solarmodule tragen.
Ihre offenen Fragen
Sie stellen eine Reihe von Fragen, die sie nicht beantworten, was ich deutlich mehr respektiere, als etwas vorzutäuschen. Drei davon sind mir im Gedächtnis geblieben.
Sollten wir die Forschung an einem neuen Paradigma verbieten, das KIs erheblich leistungsfähiger machen würde? Ich weiß es nicht. Mein Gefühl sagt mir, dass es da draußen einen abrupten Wendepunkt gibt, an dem jemand das richtige Modul an einen Agenten andockt und die Sache einfach gelaufen ist, wer zuerst dort ankommt, hat gewonnen, und kein Vertrag überlebt das. Aber ich kann euch nicht sagen, wo dieser Punkt liegt oder wie er aussieht, also tue ich auch nicht so, als hätte ich dafür eine Patentlösung.
Sollten wir verlangen, dass Chains of Thought interpretierbar bleiben? Ich glaube eigentlich nicht. Lasst die Leute ohne trainieren.
Teils, weil es ein mühsamer Kampf gegen Windmühlen ist, der umso steiler wird, je mehr auf dem Spiel steht, und das Fachgebiet weiß das bereits. Das Paper zur Überwachbarkeit von Chains of Thought1111Paper zur Überwachbarkeit von Chains of Thought, arxiv.org, gezeichnet von rund vierzig Leuten aus OpenAI, DeepMind, Anthropic und METR, sagt ganz offen, dass Lesbarkeit ein fragiles Zufallsprodukt des aktuellen Trainings ist und dass ganz normaler Optimierungsdruck zu kodiertem oder verschleiertem Denken führt. Eine Vorschrift würde also ein Trainingsregime einfrieren, nur um einen Nebeneffekt zu bewahren, der ohnehin im Verschwinden begriffen ist.
Vor allem aber geht es um den Durchsatz. Eine interpretierbare Chain of Thought bringt nichts, wenn es schlicht zu viel davon gibt. Perfekt lesbares Denken in solchen Mengen bleibt trotzdem ungelesen. Lesbarkeit stirbt an der schieren Skalierung, noch bevor sie an Verschleierung stirbt.
Treten wir also einen Schritt zurück und schauen uns an, wie wir diese Dinger eigentlich herstellen. Wir züchten diese Modelle, wir programmieren sie nicht. Das ist der entscheidende Punkt, und ich glaube, das ist der Blickwinkel, der “Plan A” fehlt. Jede Governance-Idee in dem Dokument zielt auf ein gebautes Artefakt ab: inspizieren, stoppen, auditieren, seine Gedankengänge lesen. Das sind alles Maßnahmen gegen etwas, das konstruiert wurde. Man kann sich keinen guten Garten herbeiprüfen.
Was ich mir stattdessen wünschen würde, ist, Anfangsbedingungen und Einschränkungen so zu definieren, dass es von vornherein unmöglich ist, dass die Chain of Thought an einem schlechten Ort landet. Nicht nachweisbar, unmöglich. Ich habe keine Ahnung, wie man das anstellt, und vielleicht ist das nicht einmal eine schlüssige Forderung, aber genau da wandern meine Gedanken sofort hin, und ich würde das Forschungsgeld lieber dort investieren als in ein besseres Mikroskop.
Sollten wir KIs KI-Forschung betreiben lassen? Ja, definitiv, aber mit demselben Ansatz darunter.
Im Moment kodieren wir Verhalten. Man sättigt die Trainingsdaten mit einer Eigenschaft und das Modell übernimmt sie, genauso wie ein Kind schwimmen lernt. Niemand drückt ihm Regeln in die Hand; man steckt es oft genug ins Wasser und irgendwann kann es schwimmen. Das funktioniert, und so funktioniert das alles hier. Das Problem ist: Das Kodieren von Verhalten liefert einem nur den Output und sonst nichts. Sobald sich das Modell also in einer Situation befindet, auf die man es nicht trainiert hat, imitiert es bloß und bricht zusammen.
Kodiert stattdessen den Anreiz. Kodiert den Grund, warum etwas getan wird. Ein Modell, das den Grund in sich trägt, kann in einer unvorhergesehenen Situation den richtigen Zug herausfinden, weil es den Generator in sich trägt und nicht nur den Output. Das ist es, was Steuerung tatsächlich bedeuten würde.
Mir ist klar, dass das der ungelöste Teil ist. Reward Modeling versucht seit Jahren genau das und verliert immer wieder gegen Modelle, die die Metrik statt des Ziels lernen. Ich behaupte nicht, die Lösung zu haben. Ich sage nur, dass ich das Geld dorthin leiten würde, und wo ich schon dabei wäre, auch in Informationstheorie und Neurowissenschaften, denn einer der wirklich guten Nebeneffekte dieses Feldes ist, dass wir ganz nebenbei immer wieder Dinge über uns selbst lernen.
Zwei Ebenen
Es lohnt sich, das zu trennen, weil ich es beim ersten lauten Aussprechen selbst vermischt habe.
Da ist der Teil, den man vor dem Durchlauf festlegt: Einschränkungen, die bei der Initialisierung gewählt werden und entscheiden, welche Trajektorien überhaupt erreichbar sind. Hier beobachtet man nichts. Man wählt einen Raum, der eng genug ist, dass die schlechten Regionen gar nicht erst darin liegen. Einmal entschieden, strukturell, fertig.
Dann ist da der Teil, der während des Durchlaufs aktiv ist: Anreize, die im Modell leben und es während der Arbeit lenken. Kontinuierlich, live und immer noch keine Aufsicht, weil nichts von einem Menschen ausgelesen und beurteilt wird.
Beides sind Interventionen und keines von beiden ist ein Auslesen. Was ich ablehne, ist das Inspect-and-Correct-Prinzip, die Schleife, in der jemand ein Transkript liest und entscheidet. Ich lehne nicht die Idee ab, überhaupt etwas zu tun.
Was ich denke
Das ist derselbe Schluss, zu dem ich schon bei der Chatkontrolle gekommen bin, und mir ist klar, dass ich mich da langsam wie eine kaputte Schallplatte anhöre. Aber ich lande immer wieder aus völlig unterschiedlichen Richtungen hier, also muss ich irgendwann annehmen, dass es am Gelände liegt und nicht an mir.
Festgeschriebene Regeln überleben den Kontakt mit Menschen nicht. Nicht weil Menschen böse sind, sondern weil Regeln ständige Durchsetzung durch Menschen erfordern, Menschen, die müde werden, geschmiert werden, ersetzt werden, überstimmt werden und das Interesse verlieren. Die Überwachungsseite muss nur ein einziges Mal gewinnen. Die Seite der Compute-Pause muss jedes einzelne Jahr bis 2040 gewinnen.
Was es sich also zu bauen lohnt, ist das, was von niemandem verlangt, sich immer wieder aufs Neue dafür zu entscheiden. Macht Massenüberwachung architektonisch unmöglich statt illegal, woran ich mit ØCLOAK1212ØCLOAK, github.com herumtüftle. Macht einseitige Compute-Akkumulation strukturell unmöglich statt völkerrechtlich verboten. Gestaltet den Herstellungsprozess selbst so, dass man nicht über eine bestimmte Linie hinaus trainieren kann, ohne die Zustimmung einer Reihe anderer Leute zu haben, weil die Zustimmung eine physische Abhängigkeit ist und keine bloße Unterschrift.
Ich habe diesen Entwurf nicht. Ich möchte unmissverständlich klarstellen, dass ich ihn nicht habe, dass er vielleicht unmöglich ist und dass »macht es strukturell unmöglich« leicht gesagt ist und der Schlusssatz etlicher Essays von Leuten war, die danach keinen Finger krumm gemacht haben. Aber es ist die einzige Kategorie von Antworten, die ich gefunden habe, die von Menschen nicht verlangt, fünfzehn Jahre am Stück wachsam zu bleiben, und ich habe noch nie erlebt, dass Menschen das schaffen.
Das andere, was ich sagen will, und vielleicht liege ich auch hier falsch, ist: Ich glaube, Plan B ist das, was tatsächlich passieren wird. Wir bekämpfen China, oder wir verbringen ein Jahrzehnt damit, uns darauf vorzubereiten. Ich schlage mich da auf keine Seite. Ich traue den Tech-Oligarchen, die das in den USA vorantreiben, nicht im Geringsten, ich traue Peking genauso wenig, und es gibt Tage, an denen ich denke, dass China das Ganze vielleicht besser hinbekommen würde, was ein unangenehmer Satz ist, wenn man ihn tippt.
Aber genau das ist der Knackpunkt. Ich traue keinem von ihnen, weil es alles Menschen sind, die etwas von dieser Tragweite in den Händen halten. Solange Menschen hier das Sagen haben, sind wir meiner Meinung nach ziemlich gründlich am Arsch. Und nein, das bedeutet nicht, dass stattdessen KI das Sagen haben sollte, darauf will ich überhaupt nicht hinaus. Es bedeutet, dass wir unsere Zeit darauf verwenden sollten, bestimmte Dinge unmöglich zu machen: die massenhafte Anhäufung von Compute, die massenhafte Anhäufung von Wohlstand, die massenhafte Anhäufung von irgendetwas, damit es schlicht weniger darauf ankommt, wer gerade am Drücker ist.
Sechzig Tage von der Veröffentlichung bis zu einem maschinell überprüften Beweis für ein Millennium-Problem. Der erste Verhandlungsmeilenstein ist 2029.
Ich hoffe, sie haben recht und ich irre mich. Wirklich.
~ A.