聊聊 Plan A
AI Futures Project 希望中美两国将超级智能的研发暂停至 2040 年。这是个好计划。但在他们发布该计划 60 天后,一万个智能体解出了 Navier-Stokes 方程。
时间线
2026 年 7 月 9 日,AI Futures Project 发布了 AI 2040: Plan A11AI 2040: Plan A, ai-2040.com。整整有 90 页。该提案建议中美两国在 2029 年前达成谈判,公开各自的算力储备,允许对方检查员进入自己的基础设施,暂停前沿模型训练,然后在有人造出比最聪明的人类还要聪明的存在之前,花上十年时间公开进行对齐研究。超级智能被推迟到 2040 年,大家都能活下来。
2026 年 9 月 8 日,OpenAI 宣布大约一万个协同工作的自主智能体发现了三维 Navier-Stokes 方程的有限时间奇点22大约一万个协同工作的自主智能体发现了三维 Navier-Stokes 方程的有限时间奇点, openai.com。背后的模型是一个高于 GPT-6 Astra 的内部模型。他们同时给出了分析证明和 Lean 形式化证明,因此该结果是经过机器检验的,而非口头断言。他们放弃领取那 100 万美元的奖金33放弃领取那 100 万美元的奖金, quantamagazine.org,并将整件事作为一份关于技术发展速度究竟有多快的报告呈现出来。
前后不过 60 天,而 “Plan A” 的第一个里程碑是在 2029 年。
在开始拆解之前我想先说明一点:我认为 “Plan A” 是个好计划。这是我见过的最严肃的尝试,它不是用口号,而是用可操作的细节描绘了“不搞军备竞赛”究竟会是什么样子,写这份计划的人显然绝顶聪明。任何针对此事的方案都难免招致反对,我无意去落井下石唯一做足了功课的这群人。但我通读之后,总是撞上同一堵墙:其中的几乎所有内容,都预设了你能看清正在发生什么。
“Plan A” 说了什么
给没读过的人梳理一个简要版本,你真应该去读读看,因为它写得很好。
他们指出了两种他们认为不可接受的结果44两种他们认为不可接受的结果, ai-2040.com:人类失去对 AI 的控制,或者少数高管与官员最终对超级智能形成暂时的垄断。把第二点写进去至关重要,而许多争论此问题的人往往只盯着第一点。
核心原则包括:争取时间、彻底的研究透明度、广泛扩散 AI 以及可逆性。时间线大致如下:2029 年双方完成谈判并暂停前沿训练,公开算力储备并审查供应链记录。从 2030 到 2035 年,在安全论证监管(safety-case regulation)下,在人类能力范围内大规模恢复研究。到 2035 年,一切都停留在人类顶尖专家水平,接下来的十年全部用于对齐、验证、安全和公众审议,之后任何人才能更进一步。
他们选定的执行机制是算力治理,以及他们所谓的“算力互保毁灭”(mutually assured compute destruction)。算力是卡脖子的瓶颈,因为算力是物理存在的,而物理实体是可以被计数的。
对于中国为何会同意这一方案的问题,他们的回答很精辟,我在此直接引用:
任何担心失去控制的人,以及任何担心权力过度集中(除了那些天然会获得集中权力的人)的人,都应该认为这个计划是一种改进
这句话说得很犀利。但它对人类画像的勾勒在我看来未免太整齐划一了。人可不会整整齐齐地被划分为担心失控的人、担心集权的人以及获益者。一个人身上往往同时揣着八九种动机,一半都很蠢,有些出于自我膨胀,有些出于报复,而且系统里总会有至少一个人脑子真心不正常,纯粹想看世界陷入混乱。这份计划读起来就像是为一种总能抱持善意进行理性辩论的物种量身定做的,我也希望能生活在那样的地方。
总之,从这里开始,我的看法就和他们分道扬镳了。
自我改进不需要更多算力
“Plan A” 把算力视为瓶颈。数一数芯片,数一数晶圆厂,盯紧电力消耗,你就能知道谁有能力做什么。对于从零开始预训练前沿模型来说,这大体没错。
问题在于,自我改进不需要更多算力。它需要的是软件部署,而软件部署是根本无法追踪的。
看看现在已经交付的产品吧。Thinking Machines 推出的 Tinker55Tinker, thinkingmachines.ai 让你在笔记本电脑上写一个训练循环,就能通过四个原语在他们的分布式 GPU 上运行 LoRA 微调。Engram66Engram, engram.so 融资 9800 万美元为智能体构建持久化的结构化记忆,我恰好在这个领域竞争过,所以读过其中大部分公开资料。这些都算不上超级智能,我也没这么说。但这意味着:以更低成本实现同等能力的技术正变成一种大宗商品,而这正是“算力上限”看不见的部分。仪表盘上的读数纹丝不动,底下的走势却在一刻不停地向前推进。
这也不是我在这耍小聪明,因为他们心知肚明。来自他们自己的假设补充文件77他们自己的假设补充文件, ai-2040.com:
即使只使用极少量的算力,算法层面的进步也是完全可行的
这句话躺在附录里,却直接动摇了正文的根基。如果光靠效率提升就能把你送到前沿,那么算力上限不过是把你看得见的竞赛给锁死,而对你看不见的竞赛毫无约束力。你只不过在正门修了一道昂贵的高墙。
他们还承认,他们假设秘密项目可以在不被发现的情况下动用协议前约 1% 的算力,随后又承认这个数字接近最坏情况。我曾在伊朗生活过,我可以颇有把握地告诉你:你可以在地下藏匿海量秘密,而那些以此为本职负责搜寻的人,并没有他们想让你相信的那么专业。
研究透明不等于模型透明
这一点我完全无法苟同。“Plan A” 声称彻底的透明度
使得在 AI 中蓄意植入秘密的效忠倾向、偏见或议程几乎成为不可能
我认为这站不住脚。研究透明度涵盖的是技术手段。训练属于开发和部署,而这部分依旧是不公开的专有资产。数据配比、偏好标注、标注员是谁以及你给他们下达了什么指令、宪法原则、系统提示词。这些都不是研究技术,但如果你真想植入某种忠诚倾向,这些地方正是下手之处。你可以把食谱开源,但依然能在食材里偷偷下药。
情况甚至更糟,因为就算把完整的权重和完整的数据集摆在我面前,我也无法可靠地把它找出来。Anthropic 的休眠智能体(sleeper agents)研究88休眠智能体(sleeper agents)研究, arxiv.org在模型中训练了后门,然后再在此之上进行标准的安全性训练,结果后门依然存在。模型越大,对这种行为的保留就越牢固。对抗性训练反倒教会了模型如何隐藏触发器,而不是消除它。
所以这一断言在两处都言过其实了。你拿不到最终的产物,而就算拿到了产物也远远不够。这跟我之前在关于认知崩塌的文章中反复强调的非对称性如出一辙:生成东西很便宜,验证它却极昂贵,而目前没有任何人的预算跟得上这种成本差距。
研究何时才算完成?
就算我们真有了彻底的研究透明度,由谁来决定某项成果何时对外发布?
“研究已完成”并不是一个离散的事件。从来不会有铃声响起的那一刻。我可以花 18 个月钻研一项训练技术,同时进行测试、进行开发,还在内部悄悄上线并从真实流量中收集数据,而在整个过程中,我完全可以说真话:我依然在“进行研究”。我能在完全不撒谎的情况下,抢跑数年之久。
如果你试图通过直接监管软件开发来堵住这个漏洞,其结果就是每家涉足模型的公司都被欧盟级别的文山海海所包围,技术进步在官僚程序中窒息而亡。这很糟糕,我同样不希望看到这种结局。
其他领域其实早有解决方案,但 “Plan A” 并没有采纳。临床试验通过预先注册解决了这个问题:你在开始之前就必须申报这次运行,因此保持沉默本身就构成违规,也就无需主观判断某项研究何时才算完成。“Plan A” 希望把每次训练运行都公开发布到网上,却从未明确规定由什么来触发发布,这留下的漏洞大得足以开进一整座数据中心。
验证能做什么,不能做什么
他们构想的验证方案是:来自多国的分析师审查申报的算力清单、提出质询、质疑异常情况,并派遣检查员进入彼此的基础设施,从而在年底前让各方确信对方隐匿的 AI 算力不超过 1%。
我认为这行不通,我的部分理由对他们来说可能稍微有点苛刻:因为我们谈论的是去监控某种最终可能比我们聪明一百倍的东西。蚂蚁无法理解一个人在周二的心里在想些什么,而这种差距正是整个问题的核心。
不过平心而论(我初读时在这点上确实操之过急了),“Plan A” 实际上从未提议去监控超级智能。整个设计的初衷就是在 2035 年把技术停留在人类顶尖专家水平,永远不去制造比你聪明百倍的东西。所以他们会同意我的看法,并且会说“上限的意义就在于此”。行吧。那我的反对意见就退回一步,落在这个上限到底能不能守得住,关于这点,请回看上面整整一节关于软件的讨论。
他们确实建议尽早对验证研究进行投资,这是对的,我一开始轻描淡写地略过确实有些武断。但看看他们在有效工具尚未就绪时列出的备用方案吧:依靠情报收集和卫星监控;大批量采购现成设备和网络分流器;关闭部分算力直至更好的工具出现;或者干脆不暂停,任由能力提升再持续数月。
第一条已经在我们所有人身上时刻发生着。第二条也已经在做了。第三条根本不可能发生,因为没人会主动断绝财路。第四条则是你什么都不做时的默认现状。
因此,备用阶梯的终点就是现状本身,这说明它根本算不上一架阶梯。
验证能给我们带来一种“我们清楚局势”的安全感。这并非毫无价值,协同行动确实需要共同的信念。但这与“掌控”完全是两码事,而我认为这份文件把这两者混为一谈了。
算力互保毁灭
这种构想是个好主意。它是一个切实的硬性条件,清晰明确,并且能建立起一种持久的激励机制去改变行为,而不是仅仅口头描述什么是良好行为。作为权宜之计,我很赞同它。
但我认为他们没有把这种机制会对人类心理产生的影响计入成本。
初版威慑机制已经把我们折磨得够呛了。核威慑在过去的 80 年里持续制造着背景恐惧,如今已深深烙印在大概三代人的骨子里。而“算力 MAD”在某个特定方面更为恶劣:核威慑有着清晰可见的离散触发点。人人都知道什么是导弹发射。但算力毁灭的触发阈值却是无人可见的,裁决它的还是我刚刚花了整整两节论证其无效的验证系统。因此,人们的焦虑永远无法绑定在一个具体的事件上,只能无休无止地持续蔓延。
是的,就算引爆几枚核弹我们也能挺过来。其实不行,我们挺不过来。算了,当我没说。
但这恰恰证明了问题所在。我这句自我安慰的话才说到一半,自己就听不下去了。
我喜欢的部分
广泛扩散智能。这是我会保留并在此基础上继续拓展的原则,也是 “Plan A” 中最有趣的地方,因为这部分真正针对的是“权力集中”这一失效模式,而非“失去控制”。
如果一切都公开发布,任何拥有推理硬件的人都能运行它,那么就没有人能形成垄断,因为没有任何人能保有秘密。这是对他们提出的第二种不可接受结果的切实回应,而且比这场争论中大多数人给出的答案都要好。
我想把它推得更远,让它在物理层面上落地。
目前我们构建算力的方式,和过去三十年构建其他一切基础设施如出一辙:集中建设,放在电费便宜的地方,让周围的邻居去承受噪音。人们理所当然地讨厌这样,现在很多地方的社区都在因噪音、水资源消耗和电网负荷等问题与数据中心对抗。
为什么非得是这种形态?为什么不能把 GPU 分散到整座城市中?将废热和循环水并入现有的公共管网中,对算力的投资就变成了对电网与供热管网建设的投资,这就成了一项造福所有人的公共产品,包括那些对 AI 毫不关心的人。外部性由此转化为了输入资源。
这绝非凭空假设,因为芬兰已经在供热方面付诸实践了。Espoo 有一座数据中心,正将其余热输送到区域供热网络中,惠及六位数的人口。噪音和扰民问题,本质上是把数据中心设计成孤岛带来的恶果。若将其设计成管网的参与者,大部分抱怨便会烟消云散。
至于技术层面的反对意见(即互联带宽不足以支撑跨城市训练)正被实际的研究成果逐步瓦解。DiLoCo99DiLoCo, arxiv.org 证明了同步频率可以远低于所有人的预期。Prime Intellect 利用志愿者提供的 GPU 在开放互联网上训练了一个 10B 模型,并报告称相较于标准数据并行训练,通信带宽减少了 400 倍1010报告称相较于标准数据并行训练,通信带宽减少了 400 倍, arxiv.org。Nous Research 的 DisTrO 也在朝同一方向发力。去中心化训练是一项已经产出成果的真实科研项目,而非单纯的思想实验。
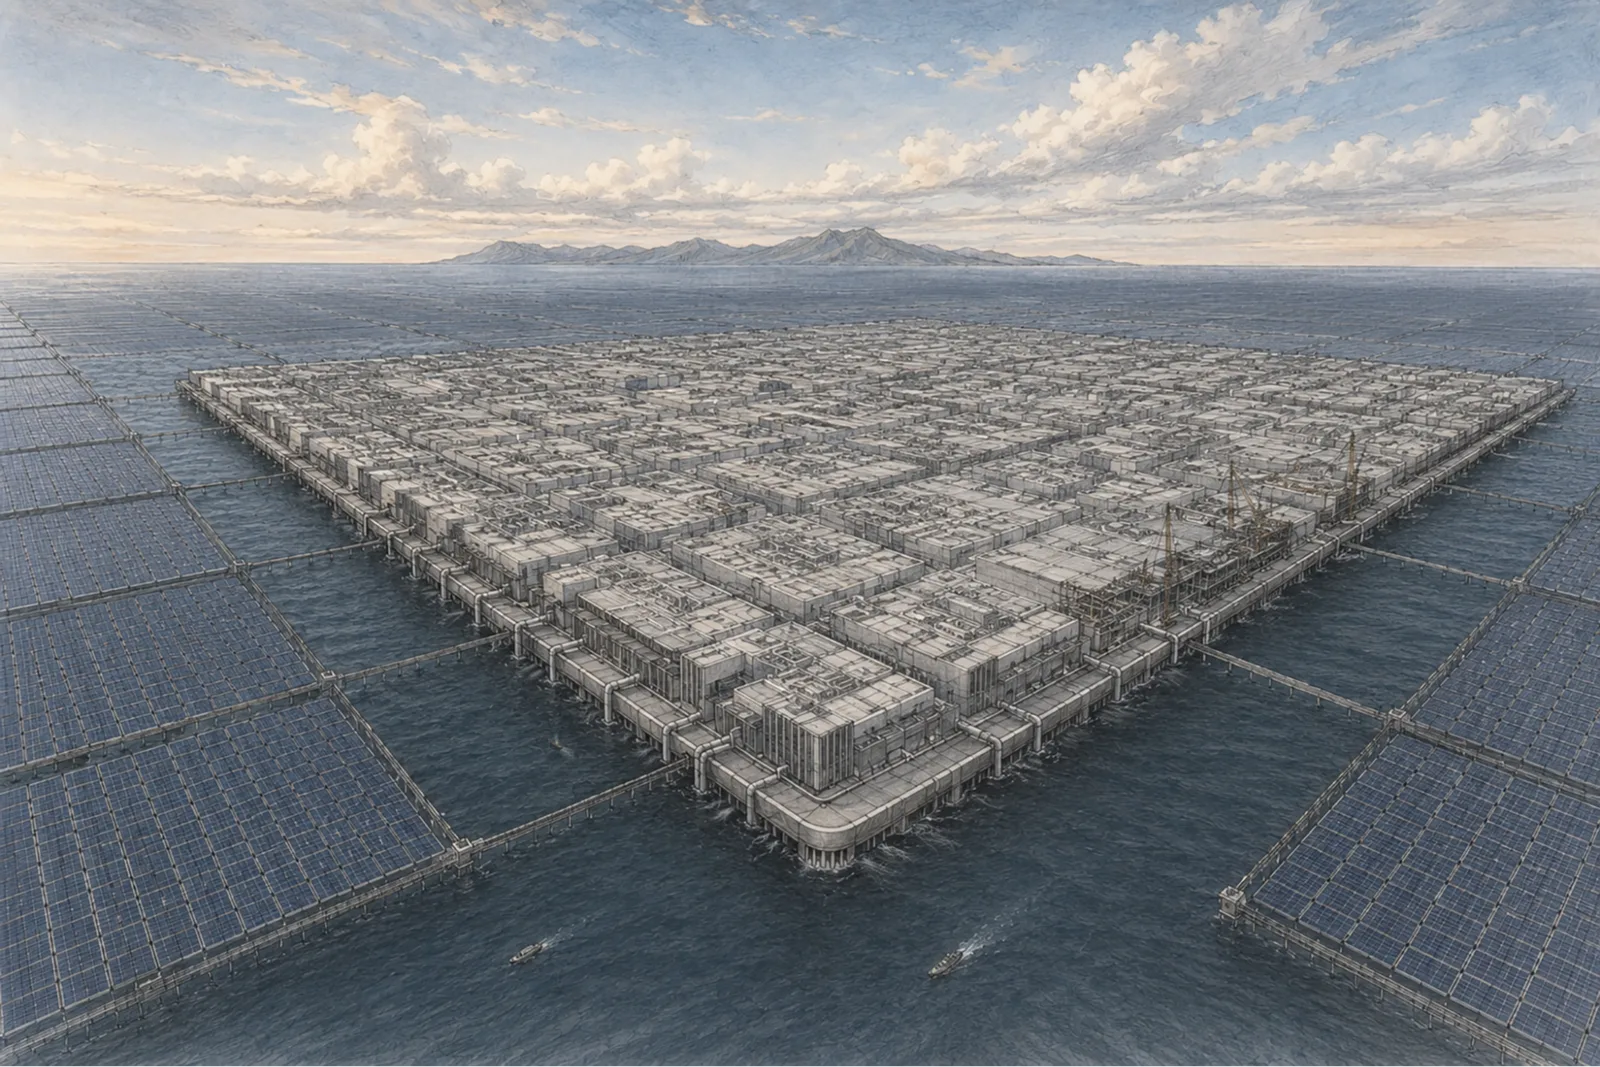
不过有一点,这里我可能对 “Plan A” 的美工部门有点挑剔了。报告里有一张插图,展示了一个由 AI 设计的模块化浮动平台,上面集成了太阳能、电池和计算单元,看起来很赞,我也真心希望能看到它建成。但仔细瞧瞧它:它是一个庞大连续的巨型单体结构,拥有单一的边界。其美学理念是“扩散”,其物理形态却是一个“学会了游泳的数据中心”。我的方案和那个方案,不过是铺着同款太阳能板的两种截然不同的构想。
他们悬而未决的开放问题
他们提出了一系列自己未作解答的问题,相比于不懂装懂,我对此要尊重得多。其中有三个问题一直萦绕在我脑海中。
我们是否应该禁止研究能使 AI 能力大幅跃升的新范式?我不知道。我的直觉是,未来存在某个剧烈的拐点,一旦有人给智能体装上了正确的模块,游戏就直接结束了,谁先到达谁就通吃,没有任何条约能在这种冲击下幸存。但我无法告诉你那个拐点在哪里、长什么样,所以我不会假装自己有什么政策良方。
我们是否应该强制要求思维链保持可解释性?我其实觉得不应该。就让人家不受此限制地去训练吧。
部分原因在于,这是一场随着风险提高而愈发艰难的硬仗,业内对此心知肚明。那篇由 OpenAI、DeepMind、Anthropic 和 METR 等机构约四十人联合签署的思维链可监控性论文1111思维链可监控性论文, arxiv.org就坦言:可读性只是当前训练方式中脆弱的偶然副产物,普通的优化压力就会催生出编码化或混淆化的推理过程。因此,强行推行禁令等于为了保住一个注定要消亡的副效应而将训练机制生硬冻结。
不过更主要的原因在于吞吐量。如果推理内容过于庞大,可解释的思维链也毫无用处。在这种体量面前,即使推理过程写得再清晰易懂,人类也没法读完。可读性在死于混淆之前,早就先死于规模了。
退一步看看我们到底是如何制造这些东西的吧。我们是在“培育”这些模型,而不是在“编写程序”。这就是关键所在,我认为这也正是 “Plan A” 所遗漏的核心框架。文件中的每一个治理设想都针对的是一个“人造构件”:检查它、叫停它、审计它、读取它的推理。这些全都是对付某种被人工搭建出来的物件的招数。但你不可能靠“检查”来打理出一个繁茂的花园。
我想要的,是在一开始就定义好初始条件和约束,让思维链从根本上就不可能走向恶意的境地。不是“可检测”,而是“不可能”。我不知道具体该怎么做,这甚至可能不是一个自洽的诉求,但这正是我脑海中瞬间浮现的想法,我宁愿把科研经费砸在这里,也不愿花在造一台更好的显微镜上。
我们是否应该允许 AI 开展 AI 研究?是的,绝对应该,但底层同样需要这种逻辑。
目前我们编码的是行为。你在训练数据中大量灌输某种特征,模型就会习得它,就像小孩子学游泳一样。没人会递给他们一本规则手册,你只要把他们扔进水里足够多次,他们最终就能游得很好。这招行得通,眼前的一切也正是这么运转的。问题在于,编码行为只给你输出了表面结果,别无其他;因此一旦模型处于未训练过的新场景,它就只能机械模仿,随后彻底崩盘。
取而代之的,应该是编码动机。去编码做这件事的“理由”。一个理解底层理由的模型,能在谁都没预料到的新情境下自行推导出正确的做法,因为它掌握的是生成器本身,而不是死板的输出。这才是真正意义上的“引导”。
我深知这是尚未解决的难题。奖励建模多年来一直试图做到这点,却屡屡败给那些学会了“迎合衡量指标”而非“实现真正目标”的模型。我并不是说我已经掌握了解法。我只是说,换作是我,我会把钱投向这个方向;顺便我还会把钱投向信息论和神经科学,因为这个领域真正美妙的一个副效应就在于:我们总是在不经意间加深了对人类自身的了解。
两个层级
有必要将这两者区分开来,因为我第一次讲出来时把它们给搞混了。
第一部分是你运行前设定的内容。在初始化时选定的约束,决定了哪些轨迹是根本可达的。在这个环节你不需要监视任何东西。你挑选了一个足够狭窄的空间,让危险区域根本不在其中。一次性决定,结构性约束,搞定。
第二部分是在运行期间生效的内容。内嵌于模型内部的激励机制,在模型工作时对其进行引导。持续、实时,但依然不需要人工监督,因为没有任何东西需要被读出来交由人类评判。
这两种都是干预手段,且都不属于“读取审查”。我所反对的是“检查并纠正”,即由某人阅读记录并作出裁决的闭环。我反对的绝非“有所作为”这一想法本身。
我的看法
这与我针对 Chat Control 得出的结论完全一致。我知道自己在这事上快变成老调重弹了,但我从完全不同的方向反复推导,最终都通向这里,所以到某个节点我不得不承认:问题出在地形本身,而不是我的方向感。
写在纸面上的规则一旦与人性接触就荡然无存。这倒不是因为人类生性邪恶,而是因为规则需要人类持续不断地去执行,而人类会疲惫、会被收买、会被撤换、会被否决、也会感到厌倦。监控派只需赢一次就行。而主张算力暂停的一方,必须在 2040 年之前的每一年都取得胜利。
因此,真正值得构建的,是那种不需要任何人持续做出抉择的机制。让大规模监控在架构上变为不可能,而不是仅仅宣布其违法,这正是我通过 ØCLOAK1212ØCLOAK, github.com 正在探索的方向。让单方面积累算力在结构上变为不可能,而不是仅仅由条约禁止。让制造工艺本身做到:如果不经多方同意,你就无法越线训练,因为这种同意是一种物理依赖,而不是一纸签名。
我手里并没有这样的设计方案。我想非常坦白地说明:我没有方案,这甚至可能根本做不到,而且“让它在结构上变为不可能”说说容易,多少人把它当作文章结语后便拍拍屁股什么都不做了。但这却是我能找到的唯一一类不需要人类连续十五年保持警惕的答案,而在我的见识里,人类还从来没有做到过这一点。
另外我还想说一点(在这点上我也可能会错):我认为 Plan B 才是真正会上演的剧本。我们要么同中国开战,要么花上十年秣马厉兵。在这场对抗中我不站任何一边。我连一丝一毫都不信任美国操盘这一切的科技寡头,我同样不信任北京,有时我甚至觉得中国可能会处理得更好,打出这句话让我心里很不舒服。
但这就是破绽所在。我谁都不信任,因为他们都是手握这等庞然巨物的人类凡夫。只要还是人类在掌舵这件事,我认为我们就彻底完蛋了。不,这绝不意味着应该换作 AI 来掌舵,我完全不是这个意思。我的意思是,我们应该把时间花在让某些事情“在物理/机制上无法做到”上面。大规模算力积累、大规模财富积累、任何形式的大规模积累,从而让“究竟谁在掌权”变得无关紧要。
从方案发布到千禧年大奖难题获得机器验证的证明,仅仅过了 60 天。而谈判的第一个里程碑却在 2029 年。
我希望他们是对的,而我是错的。我是真心的。
~ A.