プランAについて話そう
AI Futures Projectは、米中が超知能(superintelligence)の開発を2040年まで一時停止することを望んでいる。筋のいい計画だ。彼らがそれを公開してから60日後、1万のエージェントがNavier-Stokes方程式を解いてしまった。
タイミングの話
2026年7月9日、AI Futures ProjectはAI 2040: Plan A11AI 2040: Plan A, ai-2040.comを公開した。90ページに及ぶ大作だ。その提案内容は、米中が2029年までに交渉をまとめ、保有する計算資源(compute)を申告し、互いのインフラに査察官を受け入れ、フロンティアモデルのトレーニングを一時停止したうえで、人類で最も賢い人間を超えるものを誰かが生み出してしまう前に、オープンな環境で10年間アライメント研究に費やす、というものだ。超知能の登場は2040年まで先送りされ、全員が生き残る。
2026年9月8日、OpenAIは協調する約1万の自律エージェントが、3次元Navier-Stokes方程式における有限時間特異点を発見した22協調する約1万の自律エージェントが、3次元Navier-Stokes方程式における有限時間特異点を発見した, openai.comと発表した。背後にあるモデルは、GPT-6 Astraを超える社内モデルだった。彼らは解析的証明とLeanによる形式化の両方を提示したため、この結果は単なる主張ではなく機械的に検証されたものだ。彼らは100万ドルの賞金の受け取りを辞退し33100万ドルの賞金の受け取りを辞退し, quantamagazine.org、事態がいかに急速に進んでいるかを示すレポートとして全体を位置づけた。
公開からわずか60日の出来事だ。そしてプランAの最初のマイルストーンは2029年である。
この計画を解体し始める前に明確にしておきたいが、私はプランAを優れた計画だと思っている。スローガンではなく運用の詳細レベルで「開発競争を止める」とは実際にどういうことかを書き下ろした試みとして、私がこれまで見た中で最も真剣なものだし、これを書いた人たちが明らかに優秀であることも間違いない。この手の計画には必ず反対意見が出るものだし、きちんと宿題をこなした唯一のグループに追い打ちをかけるつもりはない。だが読んでいくうちに、私は何度も同じ壁にぶち当たった。それは、この計画のほぼすべてが「何が起きているかを見通せる」という前提に立っているという点だ。
プランAの主張
まだ読んでいない人のために短くまとめておく(良い内容なのでぜひ読むべきだ)。
彼らは受け入れがたい2つの結末44受け入れがたい2つの結末, ai-2040.comを挙げている。人類がAIの制御を失うこと、そして一握りの経営者や政府高官が超知能を一時的に独占することだ。2つ目が含まれていることは重要で、この議論をする人の多くは1つ目しか追っていない。
基本原則は、時間の確保、完全な研究の透明性、AIの広範な普及、そして可逆性だ。タイムラインはおおよそ次のようになる。2029年に両陣営が交渉してフロンティアモデルのトレーニングを停止し、計算資源の保有状況を申告してサプライチェーンの記録を監査する。2030年から2035年にかけては、安全ケース(safety-case)規制のもとで、人間の能力範囲内に限って大規模な研究を再開する。2035年には人間の最高峰のエキスパートレベルですべてを停止し、それ以降は誰かが先へ進む前に、残りの10年間をアライメント、検証、セキュリティ、そして国民的議論に費やす。
彼らが拠って立つ強制メカニズムは、計算資源ガバナンスと、彼らが言うところの「計算資源の相互確証破壊」だ。計算資源がチョークポイントになるのは、それが物理的なものであり、物理的なものは数えられるからだ。
「なぜ中国がこんなものに合意するのか」という問いに対する彼らの答えは秀逸なので引用しておこう。
制御の喪失を懸念する人なら誰でも、この計画を前進だと考えるはずだ。権力の集中を懸念する人も同様である。ただし、デフォルトで権力が集中する当人たちを除いては。
巧みな言い回しだ。だが同時に、人間というものをあまりに綺麗に捉えすぎているようにも思える。人間は、制御の喪失を心配する人、権力の集中を心配する人、そしてその恩恵を受ける人、というようにすっきりと分類できるものではない。人間は同時に9個くらいの動機を抱えていて、その半分はくだらないもので、一部はプライドで、一部は復讐心で、そして関係者の中には絶対に1人くらい、純粋に精神を病んでいて「何が起きるか見てみたい」だけの人間がいるはずだ。この計画はまるで、全員が善意で議論する種族のために書かれたかのようで、そんな世界に住めたらどんなにいいだろうとは思う。
ともかく、私が違和感を覚え始めるのはここからだ。
自己改善にさらなる計算資源は要らない
プランAは計算資源をチョークポイントとして扱う。チップを数え、ファブを数え、消費電力を監視すれば、誰が何をできるかがわかるというわけだ。フロンティアモデルを一から事前学習(pretraining)する分には、基本的にその通りだろう。
問題は、自己改善(self-improvement)にはそれ以上の計算資源が必要ないということだ。必要なのはソフトウェアのデプロイであり、ソフトウェアのデプロイを追跡することは不可能だ。
すでに世に出ているものを見てみてほしい。Thinking MachinesのTinker55Tinker, thinkingmachines.aiを使えば、ノートPC上でトレーニングループを書き、4つのプリミティブを介して彼らの分散GPU上でLoRAファインチューニングを実行できる。Engram66Engram, engram.soはエージェント向けの永続的構造化メモリを構築するために9800万ドルを調達した。私はまさにその領域で競合していたので、公開されている情報は大半読んでいる。これらはどれも超知能ではないし、そうだと言うつもりもない。だがこれは、「同じ能力により低コストで到達する」というビジネス全体がコモディティ化しつつあることを示しており、それこそが計算資源の上限規制では見抜けない部分なのだ。メーターの針が止まっていても、その下にある線は動き続けている。
これは私が知ったかぶりをしているわけでもない。彼ら自身も分かっているからだ。彼ら自身の前提条件補足資料77彼ら自身の前提条件補足資料, ai-2040.comにはこうある。
ごく少量の計算資源であってもアルゴリズムの進歩が可能である余地はある
この一文は付録にひっそりと書かれているが、本文の根底を揺るがしている。効率の向上だけでフロンティアに到達できるのだとしたら、計算資源の上限規制は「目に見える競争」を締め出すだけで、「目に見えない競争」には何の影響も与えない。正面玄関の周りに高価なフェンスを建てただけの話だ。
彼らはまた、秘密裏のプロジェクトであっても合意前の計算資源の約1%までは検出されずに到達しうると想定しており、この数字がワーストケースに近いことを認めている。私はイランに住んでいたことがあるが、地下にはいくらでもものを隠せるし、それを見つけ出す仕事をしている連中は、自分たちが思わせたがっているほどその仕事が得意ではないと、確信を持って言える。
研究の透明性はモデルの透明性ではない
これについては私は単純に同意できない。プランAは、完全な透明性によって
秘密の忠誠心、バイアス、またはアジェンダがAIに意図的に組み込まれることをほぼ不可能にする
と主張している。そんなわけはないと思う。研究の透明性がカバーするのはテクニックだ。トレーニングとは開発とデプロイであり、その部分はプロプライエタリなままだ。データ混合比率、選好ラベル、評価者が誰で何を指示されたか、コンスティテューション、システムプロンプト。これらはどれも研究テクニックではなく、もし何らかの忠誠心を仕込みたいならまさに埋め込むべき場所だ。レシピをオープンソースにしても、材料に塩を仕込むことはできる。
それどころかもっと厄介だ。完全な重み(weights)と完全なデータセットが目の前にあったとしても、それを確実に見つけ出すことなどできないからだ。Anthropicのスリーパーエージェントに関する研究88スリーパーエージェントに関する研究, arxiv.orgでは、モデルにバックドアを仕込んだ上で標準的な安全性トレーニングを施したが、バックドアは残存した。モデルが大きくなるほど、その挙動はより強固に維持された。敵対的トレーニングを施すと、モデルはトリガーを消去するのではなく、隠蔽することを学習してしまったのだ。
つまり、この主張は2重の意味で過大だ。成果物(artifact)は手に入らないだろうし、手に入ったとしても不十分なのだ。これは私がエピステミック・コラプスに関する記事で熱弁したのと同じ非対称性だ。何かを生成するのは安上がりだが、それを検証するのは極めて高くつき、誰の予算もそれに追いついていない。
研究はいつ完了するのか
仮に完全な研究の透明性が確保されたとしよう。何かがいつ公開されるべきかは、誰が決めるのか?
「研究の完了」はイベントではない。ベルが鳴る瞬間など存在しないのだ。私が18ヶ月かけてトレーニング技術の開発を行いながら、同時にテストを行い、開発を進め、密かに社内でリリースして実際のトラフィックからデータを収集していたとしても、その全期間を通じて私は、まったくの嘘偽りなく「まだ研究を行っている」と言い張れる。嘘をひとつもつくことなく、年単位のリードを保ち続けることができるのだ。
ソフトウェア開発そのものを規制することでその抜け道を塞ごうとすれば、モデルに触れるすべての企業がEU並みの書類仕事に忙殺され、進歩はその下で窒息する。それは最悪だし、私もそんなことは望んでいない。
解決策は他の分野に存在しているが、プランAはそれを採用していない。臨床試験はこの問題を事前登録(pre-registration)で解決した。開始する前に対象の実行を宣言するのだ。そうすれば沈黙それ自体が違反となり、何かがいつ「完了」したかについての裁量の余地はなくなる。プランAはすべてのトレーニングの実行をインターネット上に公開することを求めているが、何をもって公開のトリガーとするのかを一切指定していない。これでは、データセンターが丸ごと通り抜けられるほどの巨大な穴が空いたままだ。
検証ができること、できないこと
彼らの検証シナリオはこうだ。多国籍のアナリストが申告された計算資源リストを精査し、質問を投げ、異常に異議を唱え、互いのインフラに査察官を送り込むことで、年末までに双方が「相手はAI計算資源の1%以上を隠蔽していない」と確信を持てるようにする。
これが機能するとは思えない。その理由の一部は彼らにとって少しアンフェアかもしれないが、私たちが監視しようとしている対象は、最終的に人間の100倍賢くなりうるものだからだ。アリは人間が火曜日に何を考えているかのモデルを構築することなどできないし、そのギャップこそが問題のすべてなのだ。
公平を期すために言っておくと(私も最初に読んだときは早合点してしまったのだが)、プランAは実際には超知能を監視することを提案してはいない。設計全体としては、2035年に人間の最高峰のエキスパートレベルで停止し、人間の100倍賢いものなど絶対に作らない、というものだ。だから彼らも私に同意するだろうし、それこそが上限設定の目的だと答えるだろう。いいだろう。ならば私の異論は一歩後退して、「その上限が維持できるのか」という点に向かう。そしてそれについては、ソフトウェアに関する前述のセクション全体を参照してほしい。
彼らは検証研究への早期投資を推奨しており、それは正しいし、私が最初にそれを一蹴したのは軽率だった。だが、優れたツールがまだ準備できていない場合の代替案として彼らが挙げているリストを見てほしい。諜報活動と衛星監視に頼る。市販のデバイスやネットワークタップを買い集める。より良いツールが登場するまで計算資源の一部をシャットダウンする。あるいは一時停止せず、能力の進歩を数ヶ月間そのまま放置する。
1つ目は、すでに私たち全員に対して絶え間なく行われている。2つ目もすでに起きている。3つ目は起こりえない。誰も収益源のスイッチを切ったりはしないからだ。4つ目は、何もしなければデフォルトで起きることそのものだ。
つまり、代替案の階段は現状維持(ステータスクオ)に行き着くわけで、それはもはや階段とは呼べないのではないか。
検証は「何が起きているかを把握できている」という感覚を与えてくれる。それには価値があるし、協調には共通の信念が必要だ。しかしそれは制御とは別物であり、この文書はその2つを曖昧にしてしまっているように思う。
計算資源の相互確証破壊
この枠組み自体は良いアイデアだ。明確なハードコンディションであり、分かりやすく、単に望ましい行動を記述するだけでなく行動を変えるような恒常的なインセンティブを生み出す。当座のしのぎとしては気に入っている。
だが彼らが織り込んでいないと思われるのは、それが人間に何をもたらすかだ。
私たちは、このアイデアの最初のバージョン(核)の時点ですでに参ってしまっている。核抑止は80年間にわたって漠然とした恐怖を生み出し続け、今や3世代にわたって人々に刷り込まれている。計算資源のMAD(相互確証破壊)はある特定の点でさらにタチが悪い。核抑止には目に見える明確なトリガーがある。「発射」が何であるかは誰でも知っている。一方、計算資源の破壊が発動する閾値は誰の目にも見えず、私が直前の2つのセクションで機能しないと論じた検証システムによって判定される。そのため、不安は特定のイベントに結びつくことすらできず、ただ延々と垂れ流され続ける。
それにまあ、何発かの核が爆発したとしても、私たちは復興できる。いや、実際は無理だ。今のなし、忘れてくれ。
だが、それこそが要点なのだ。私は気休めの言葉を言い終わらないうちに、自分の言っていることのヤバさに気づいた。
私が評価している部分
知能を広く普及(ディフュージョン)させること。これこそ私が維持し、さらに発展させたい原則であり、プランAが最も興味深い点でもある。なぜならこれは、「制御の喪失」ではなく「権力の集中」という失敗モードに対して実際に機能する部分だからだ。
すべてが公開され、推論ハードウェアを持つ者なら誰でもそれを実行できるなら、誰も秘密を持たないため、誰も独占することはできない。これは彼らが挙げた2つ目の受け入れがたい結末に対する真の答えであり、この議論に関わる大半の人間が持っているものよりも優れた答えだ。
私はこれをさらに進めて、物理的な形に落とし込みたい。
現状、私たちは過去30年間あらゆるものを作ってきたのと同じやり方で計算資源を構築している。集中させ、電力の安い場所に置き、騒音は近隣住民に押し付ける。当然ながら人々はこれを嫌っており、現在多くの場所で、騒音、水、電力網への負荷を巡って地域コミュニティがデータセンターと争っている。
なぜそんな形である必要があるのか? なぜGPUを都市全体に分散させてはならないのか? 排熱と水を既存のインフラ網に流し込めば、計算資源への投資はそのまま電力・熱供給網の開発への投資となり、AIに全く興味のない人々も含めた全員にとっての公共財になる。外部不経済がインプットへと変わるのだ。
これは絵空事ではない。フィンランドではすでに排熱に関してこれを実践している。エスポーにあるデータセンターは、その廃熱を10万人規模の人々のための地域暖房ネットワークに供給している。騒音や迷惑施設化の問題は、データセンターを「孤島」として設計するから生じるのだ。グリッドの参加者として設計すれば、苦情のほとんどは解消する。
「インターコネクトの帯域幅の問題で、都市全体に分散してトレーニングすることはできない」という技術的な反論も、実際の研究によって突き崩されつつある。DiLoCo99DiLoCo, arxiv.orgは、誰もが想定していたよりもはるかに低い頻度で同期できることを示した。Prime Intellectは、オープンなインターネット上でボランティアのGPUを使って10Bモデルをトレーニングし、標準的なデータ並列トレーニングと比較して通信帯域幅を400分の1に削減したと報告した1010通信帯域幅を400分の1に削減したと報告した, arxiv.org。Nous ResearchのDisTrOも同じ方向を推し進めている。分散型トレーニングは結果を出しつつある現実の研究プログラムであり、思考実験ではない。
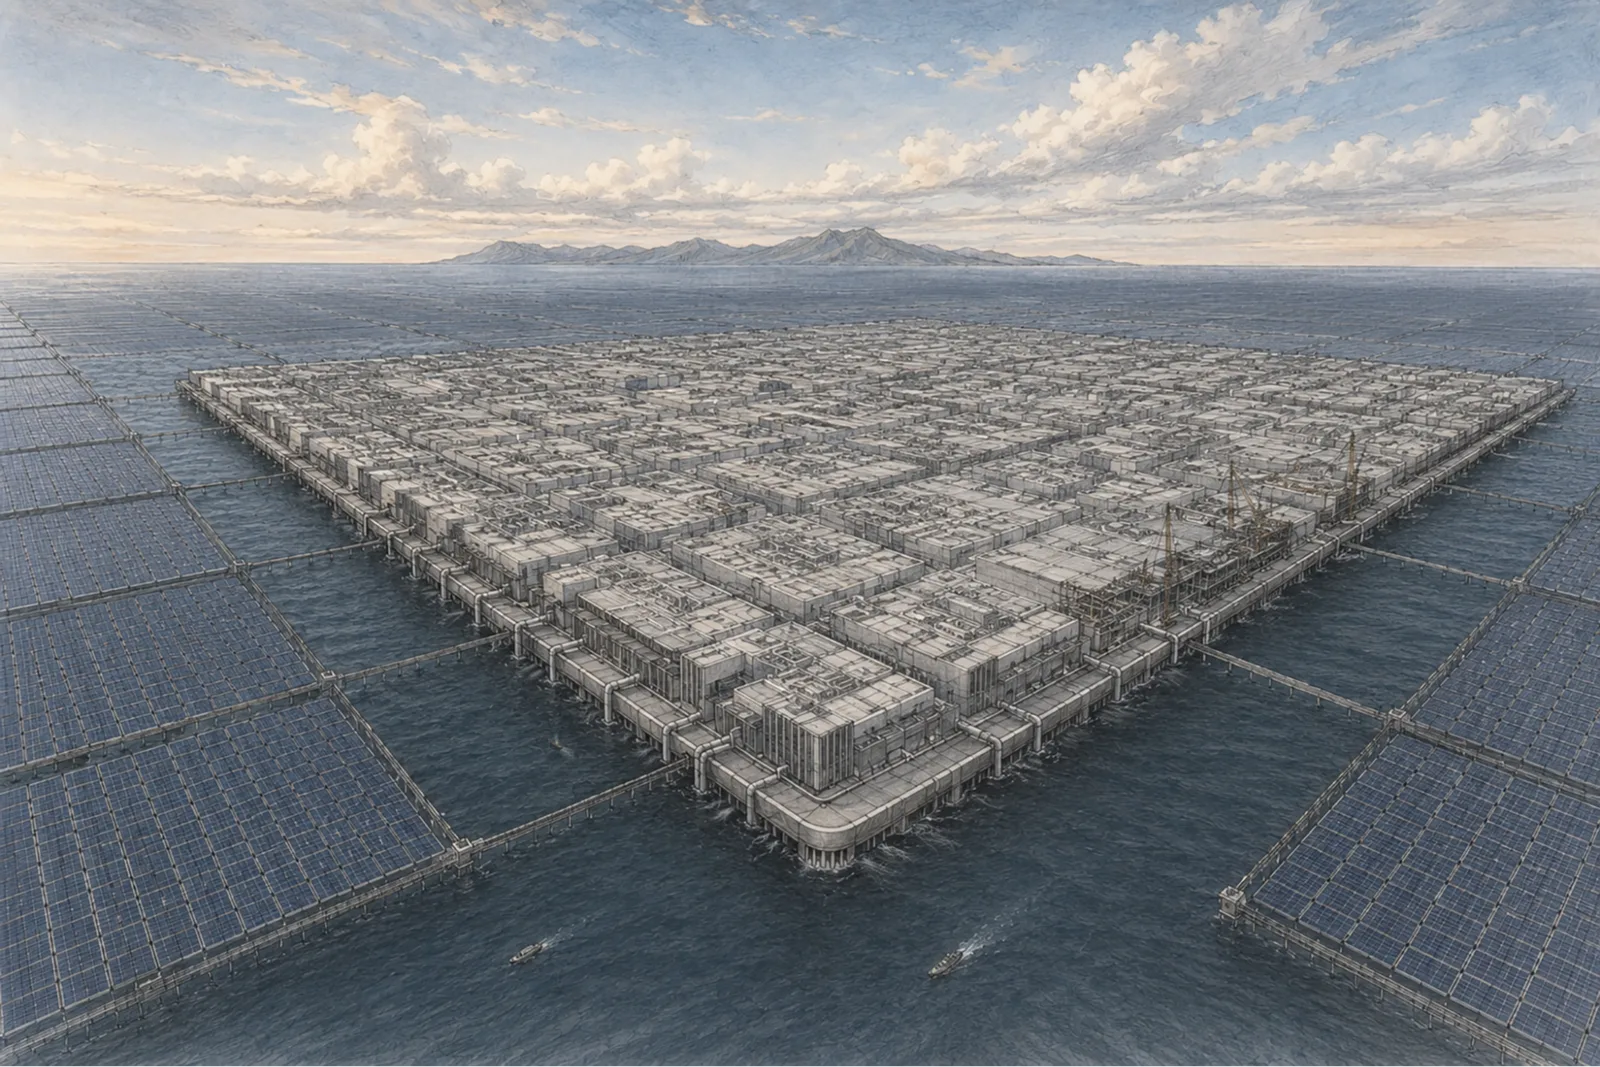
ただひとつ、ここでプランAの美術担当に少し意地悪を言わせてもらえば、レポートの中に、ソーラーパネルとバッテリーと計算資源を備えた、AI設計によるモジュール式洋上プラットフォームのイラストがある。素晴らしく魅力的だし、本当に建造されるのを見てみたいと思う。だが、よく見てほしい。それは単一のユニットとして作られた、ひとつの縁を持つ巨大で連続した塊なのだ。美学は分散(ディフュージョン)を謳いながら、その形態は「浮くことを覚えたデータセンター」に過ぎない。私のバージョンとあのバージョンは、同じソーラーパネルを身にまとった別物なのだ。
彼らの未解決の問い
彼らは自分たちでも答えを出せていない一連の問いを提示している。知ったかぶりをするより、その方がよほど好感が持てる。そのうちの3つが私の心に残り続けている。
AIを大幅に高性能化させるような新しいパラダイムの研究を禁止すべきか? 私には分からない。私の直感では、誰かがエージェントに適切なモジュールを取り付けた瞬間にすべてが不可逆的に決着し、最初にそこに到達した者がすべてを手に入れ、どんな条約も無力化するような鋭い変曲点が存在するはずだ。しかし、そのポイントがどこにあるのか、それがどんな姿をしているのかを説明することはできないので、何らかのポリシーを持っているふりをするつもりはない。
思考の連鎖(chain of thought)の解釈可能性を維持することを義務付けるべきか? 実のところ、そうすべきではないと思う。そんな制約なしにトレーニングさせればいい。
ひとつには、それが賭け金(リスク)が高まるにつれて険しさを増す一方の無理ゲーであり、この分野の研究者たちもそれをすでに知っているからだ。OpenAI、DeepMind、Anthropic、METRの約40名が連名した思考の連鎖の監視可能性に関する論文1111思考の連鎖の監視可能性に関する論文, arxiv.orgでは、可読性(legibility)は現在のトレーニングにおける脆い副産物にすぎず、通常の最適化圧力をかけるだけで暗号化された推論や難読化された推論が生成されてしまうと率直に述べられている。つまり義務化することは、どうせ消えゆく運命にある副作用を温存するためにトレーニング手法を固定してしまうことになる。
だが最大の理由はスループットだ。思考の連鎖がいくら解釈可能であっても、その量が膨大すぎれば役に立たない。その規模においては、完全に読める推論であっても結局は読まれないままだ。可読性は、難読化によって死ぬ前に、スケールによって死ぬ。
だから一歩引いて、私たちが実際にこれらをどう作っているかを見てみるべきだ。私たちはこれらのモデルを「プログラミング」しているのではなく、「育てて」いるのだ。それこそが本質であり、プランAが見落としている視点だと思う。文書内のすべてのガバナンスのアイデアは、「作られた構造物」を対象にしている。査察し、停止し、監査し、その推論を読み解く。これらはすべて、構築されたものに対するアプローチだ。どれだけ査察したところで、良い庭を育てることはできない。
私が代わりに求めたいのは、思考の連鎖がそもそも悪い場所に行き着くこと自体を不可能にするような初期条件と制約を定義することだ。検出可能にするのではなく、不可能な状態にする。どうやればそれができるのか見当もつかないし、そもそも筋の通った要求ですらないかもしれないが、私の思考は真っ先にそこへ向かう。より高性能な顕微鏡を買うくらいなら、そのための研究に資金を使いたい。
AIにAIの研究をさせるべきか? もちろんさせるべきだ。ただし、その根底には同じアプローチが必要になる。
現状、私たちは振る舞いをエンコードしている。トレーニングデータにある特性を飽和させれば、子どもが水泳を覚えるのと同じように、モデルはその特性を身につける。誰もルールを手渡したりはしない。何度も水の中に入れれば、最終的には泳げるようになる。それは機能するし、現在のすべてはそのように動いている。問題は、振る舞いをエンコードすることでは出力しか得られないため、モデルがトレーニングされていない状況に置かれた瞬間、単なる模倣になって破綻してしまうことだ。
代わりにインセンティブをエンコードするのだ。その行動をとる「理由」をエンコードする。理由を保持しているモデルなら、誰も予期しなかった状況においても正しい動きを導き出すことができる。出力ではなく生成器そのものを携えているからだ。それこそが、真の意味での「操縦(steering)」だろう。
これが未解決の部分であることは承知している。報酬モデリング(reward modelling)は何年もの間まさにこれを試みてきたが、目標ではなく測定基準そのものを学習してしまうモデルに負け続けている。私にその解決策があると言っているのではない。私ならそこに資金を投じるし、ついでに情報理論や神経科学にも資金を投じるだろう、と言っているのだ。この分野の真に素晴らしい副作用のひとつは、私たちが自分自身について図らずも学び続けていることなのだから。
2つのレイヤー
これらは分けて考える価値がある。最初に口にしたとき、自分でも混同してしまっていたからだ。
ひとつは、実行前に設定する部分だ。どの軌道に到達可能かを決定づける、初期化時に選択される制約。ここでは何も監視しない。悪い領域が含まれないように十分に狭い空間を選ぶだけだ。一度決定すれば構造的に機能し、それで完了する。
もうひとつは、実行中に動作する部分だ。モデルの内部に存在し、動作しながらそれを操縦するインセンティブ。継続的でリアルタイムだが、人間が何かを読み出して判断するわけではないので、やはりこれも「監視(oversight)」ではない。
これらはどちらも介入(intervention)であって、読み出し(readout)ではない。私が拒否しているのは「査察して修正する(inspect-and-correct)」という、誰かがログを読んで判断を下すようなループだ。何らかの手を打つというアイデアそのものを拒否しているわけではない。
私の考え
これは私がChat Controlについて至ったのと同じ結論だ。我ながらワンパターンになってきた自覚はあるが、全く異なる方向から考えても毎回ここに辿り着いてしまうのだから、自分の問題ではなく地形そのものがそうなのだと受け入れるしかない。
明文化されたルールは、人間と接触した瞬間に崩壊する。人間が悪だからではなく、ルールを維持するには、疲労し、買収され、交代させられ、多数決で負け、飽きてしまう人間による継続的な執行が必要だからだ。監視(サーベイランス)側は一度だけ勝てばいい。だが計算資源の一時停止側は、2040年まで毎年勝ち続けなければならないのだ。
だからこそ作る価値があるのは、「誰かがそれを選び続ける必要のないもの」だ。大量監視を違法にするのではなく、アーキテクチャ的に不可能にする。それが私のØCLOAK1212ØCLOAK, github.comでの試みだ。一方的な計算資源の蓄積を条約で禁止するのではなく、構造的に不可能にする。製造プロセスそのものを、多数の他者の同意なしには一定のラインを超えてトレーニングできないような構造にする。同意が署名ではなく物理的な依存関係になるようにするのだ。
私にはその具体的な設計図はない。持っていないこと、それが不可能かもしれないこと、「構造的に不可能にせよ」と言うのは簡単で、結局何もしなかった人たちによる数多くのエッセイの締めくくりに使われてきた言葉であることは、重々承知している。だがこれは、人間に15年連続で警戒を怠らないことを要求しない、私が見つけられた唯一のカテゴリーの答えなのだ。そして人間がそんな芸当を成し遂げたのを、私は一度も見たことがない。
もうひとつ言っておくと(これも私の思い違いかもしれないが)、実際に起きるのは「プランB」のほうだと思う。私たちは中国と戦うか、その準備に10年を費やすことになる。私はその争いでどちらかの味方をするつもりはない。アメリカでこれを牛耳っているテック寡頭政治家たちを微塵も信用していないし、北京も信用していない。そして日によっては、中国のほうがまだうまくやるのではないかとすら思うことがあり、自分でもタイピングしていて居心地の悪さを感じる。
だが、それこそが証拠だ。この規模のものを抱えているのが「人間」である以上、私は彼らの誰も信用できない。人間がこれを握っている限り、私たちはかなり救いようのないレベルで詰んでいると思う。そして念のために言っておくが、これは「代わりにAIに支配させろ」という意味では全くなく、私の話の着地点はそこではない。私たちが時間を費やすべきなのは、特定の行為を「不可能」にすることだ。計算資源の大量蓄積、富の大量蓄積、あらゆるものの大量蓄積を構造的に不可能にし、誰がトップにいようが関係ない状態を作ることなのだ。
計画の公開から、ミレニアム懸賞問題の機械検証された証明が出るまで、わずか60日だった。最初の交渉マイルストーンは2029年だ。
彼らの言っていることが正しく、私が間違っていることを願う。本当にそう願っている。
~ A.